Door Inogen voor SSC-ICT

Vraag het aan zeventienduizend beantwoorde Kamervragen.

Kamervragen AI doorzoekt de volledige tekst van alle schriftelijke Kamervragen en regeringsantwoorden sinds 2019, zoekt zo vaak als nodig, en schrijft een antwoord waarin geciteerde zinnen aan het letterlijke citaat uit een specifiek document hangen, met een link naar de officiële publicatie. Een onafhankelijke toets van de antwoorden laat zien hoe ver dat gaat.

16.819
beantwoorde Kamervragen
155.598
vraag-antwoordparen
95%
juiste document in de top 5
2019–2026
vergaderjaren doorzoekbaar
Een echte sessie, op ware snelheid: vier zoekopdrachten, een chronologisch antwoord en twintig geciteerde bronnen in anderhalve minuut.

Hoe het werkt

Drie keuzes maken het verschil met een gewone zoekmachine of chatbot.

1

Officiële bronnen, gestructureerd

De documentenlijst komt uit de Open Data API van de Tweede Kamer, de volledige tekst als gestructureerde XML van officielebekendmakingen.nl. Vraag en antwoord komen al gescheiden binnen: geen scraping, geen PDF-parsing, geen gemiste tekst.

2

Zoeken per vraag-antwoordpaar

Elk paar is één zoekeenheid met de documentkop erboven. Betekenisvectoren (bge-m3) en trefwoordzoeken met Nederlandse stemming worden samengevoegd en door een reranker herordend. Datum- en ministeriefilters werken in de index zelf.

3

Een agent die citeert

Claude bepaalt zelf welke zoekopdrachten nodig zijn, met welke periode, en zoekt opnieuw als de resultaten mager zijn. De antwoorden dragen citaten uit de API zelf: per geciteerde zin de letterlijke passage en het brondocument. Niets wordt achteraf gereconstrueerd.

Eenmalig Open Data API XML per Aanhangsel 1 chunk per Q&A bge-m3 + BM25 index
Per vraag Claude hybride zoeken · filters · reranker antwoord met citaten

Resultaten

Zestig door een taalmodel geschreven gebruikersvragen, doel: het brondocument terugvinden. De vorige aanpak is op hetzelfde corpus nagebouwd.

SysteemPlek 1Top 5Top 10
Vorige prototype: heel document als één vector13%27%37%
Nieuw: vectoren per vraag-antwoordpaar73%92%95%
Nieuw: hybride (vectoren + trefwoorden)72%93%98%
Nieuw: hybride + reranker80%95%97%

Antwoorden getoetst door een tweede model

Elk demo-antwoord is door Claude Fable 5.1 beoordeeld op trouw aan de bronnen, volledigheid, helderheid en attributie (4,25 van 5 op trouw na herziening van de prompt). Gemiddeld blijft ongeveer één bewering per lang antwoord over die iets verder gaat dan de bron, meestal een samenvattend kopje. De cijfers staan in de repository.

Eerlijk als het er niet is

Vraag naar iets waarover geen Kamervragen bestaan, en het systeem zegt dat. Het beschrijft wat het wél vond en stelt een scherpere vraag voor. Het verzint geen documentnummers, data of citaten.

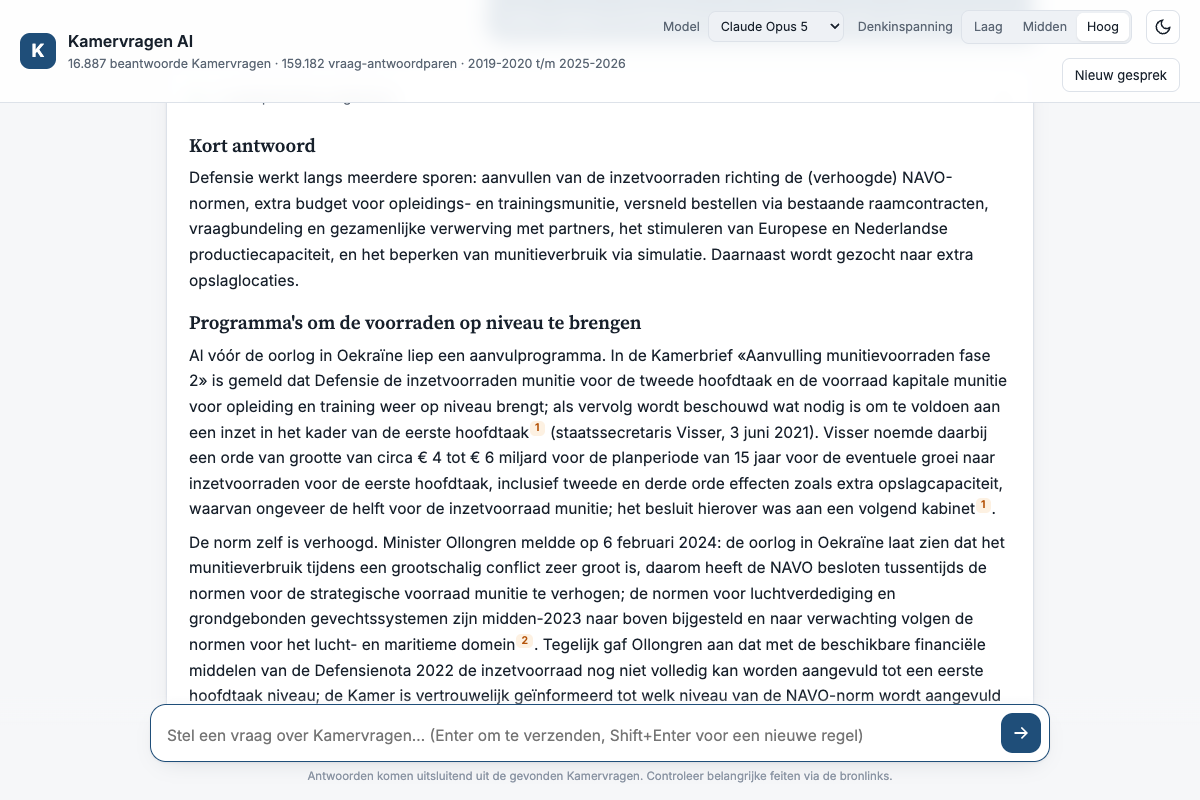
Antwoord met genummerde citaten en bronnenlijst
Citaten als genummerde markers; klik en je springt naar de bron met het letterlijke citaat.
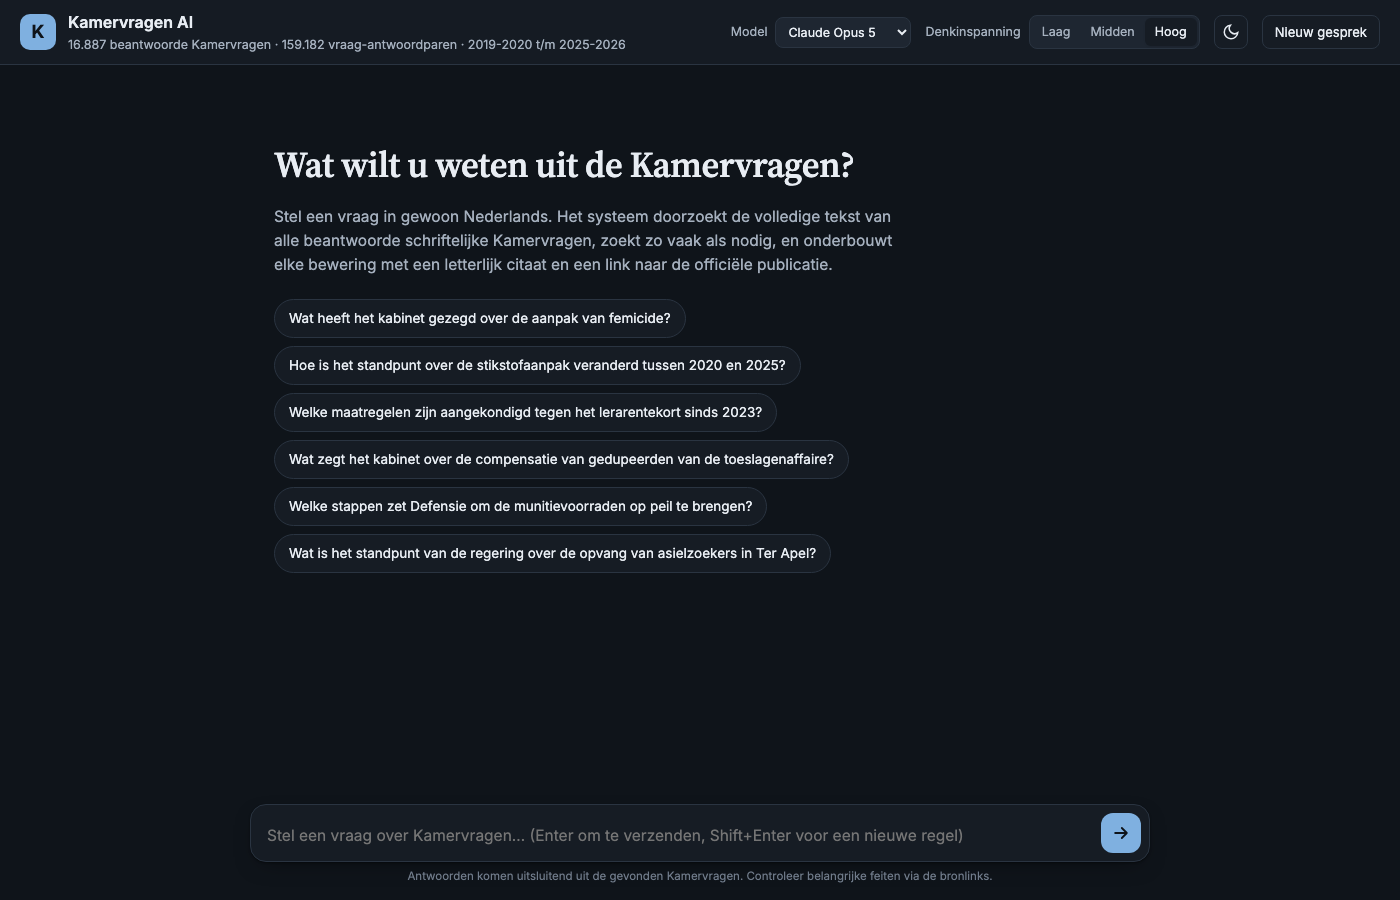
Startscherm met voorbeeldvragen in donker thema
Startscherm met voorbeeldvragen, model- en inspanningskeuze, licht en donker thema.

Aan de slag

Alles draait lokaal behalve het taalmodel. Een Anthropic API-sleutel en een laptop met 16 GB geheugen volstaan.

git clone https://github.com/inogen-ai/kamervragen-ai.git
cd kamervragen-ai && uv sync
cp .env.example .env                      # ANTHROPIC_API_KEY invullen

uv run kamervragen ingest --from-year 2019   # ~3 min, 17k documenten via de officiële API
uv run kamervragen index                     # embeddings; ~2,5 uur op een M3 Pro
uv run kamervragen serve                     # http://localhost:8000

Voor een server staat er een Docker Compose-stack met automatische HTTPS en wachtwoordbeveiliging in deploy/. De repository is privé en op aanvraag beschikbaar voor SSC-ICT.